Степени, экспонента, логарифмы
Степени
$$ a^m a^n = a^{m+n}, \quad \frac{a^m}{a^n} = a^{m-n}, \quad (a^m)^n = a^{mn}, \quad (ab)^n = a^n b^n, \quad a^{-n} = \frac{1}{a^n}, \quad a^{m/n} = \sqrt[n]{a^m} $$
Удобные числа: $2^{10} = 1024$, $2^{16} = 65\,536$, $2^{20} \approx 10^6$, $2^{32} \approx 4.3 \cdot 10^9$.
Откуда берётся число e
Сложные проценты: 100% годовых, начисляем $n$ раз в год по $100/n$ %: итог $(1 + 1/n)^n$. При $n \to \infty$ это стремится к $e \approx 2.71828$ — «непрерывный рост».
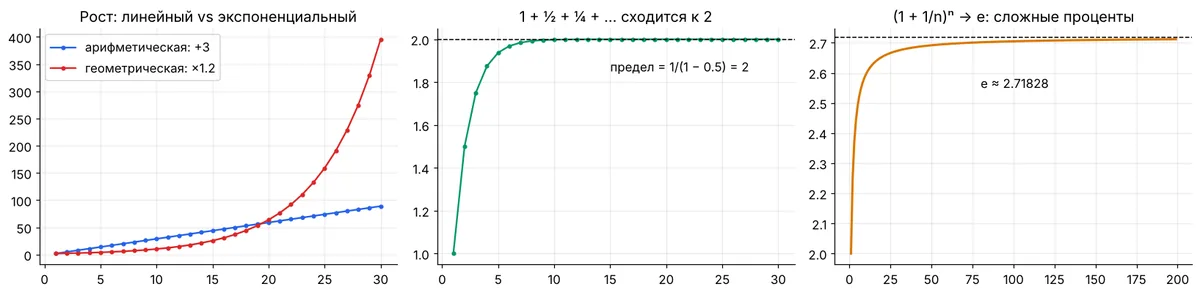
Экспонента $e^x$ — единственная функция, равная своей производной. Поэтому она везде, где «скорость изменения пропорциональна величине»: рост, затухание, softmax.
Логарифмы
$\log_a b = c \iff a^c = b$.
$$ \log(xy) = \log x + \log y, \qquad \log\frac{x}{y} = \log x - \log y, \qquad \log x^k = k\log x, \qquad \log_a x = \frac{\ln x}{\ln a} $$
| Где в ML | Почему логарифм |
|---|---|
| Cross-entropy $-\ln p$ | превращает вероятность в штраф: $p = 1 \to 0$, $p \to 0 \Rightarrow \infty$ |
| Log-likelihood | произведение миллионов вероятностей → сумма, без underflow |
| Log-scale графики | лосс, learning rate, законы масштабирования — прямые в лог-лог |
| Сложность $O(\log n)$ | бинарный поиск, деревья: каждый шаг делит задачу пополам |
| Энтропия в битах | $\log_2$ — сколько вопросов «да/нет» нужно |
🏋️ Практика Б4
Б4.1. Упростите $\ln(e^3 \cdot e^{-1})$ и $\log_2(64) - \log_2(4)$.
▶️ Ответ
$\ln e^2 = 2$; $\log_2(64/4) = \log_2 16 = 4$.Б4.2. Вероятность каждого из 1000 независимых событий — 0.99. Посчитайте вероятность, что произойдут все, через логарифм.
▶️ Ответ
$\ln P = 1000 \cdot \ln 0.99 \approx 1000 \cdot (-0.01005) = -10.05$, $P = e^{-10.05} \approx 4.3 \cdot 10^{-5}$.Б4.3. Learning rate ищут перебором по сетке 1e-5, 3e-5, 1e-4, 3e-4, 1e-3. Почему шаг сетки «×3», а не «+0.0002»?