Язык математики: обозначения, функции, логарифмы
← 00½. База для начинающих: школьная математика за один вечер · 🏠 Оглавление · 02. Линейная алгебра →
📓 Ноутбук модуля ·
Половина «непонятности» статей по ML — это просто незнакомые обозначения. Этот модуль — словарь.

Словарь обозначений
| Обозначение | Читается | Что значит | В коде |
|---|---|---|---|
| $x \in \mathbb{R}$ | x принадлежит R | вещественное число | float |
| $\mathbf{x} \in \mathbb{R}^n$ | вектор длины n | столбец из n чисел | x.shape == (n,) |
| $X \in \mathbb{R}^{m \times n}$ | матрица m на n | m строк, n столбцов | X.shape == (m, n) |
| $x_i$, $X_{ij}$ | i-й элемент | индексация (в математике с 1!) | x[i-1], X[i-1, j-1] |
| $X^\top$ | транспонирование | строки ↔ столбцы | X.T |
| $\sum_{i=1}^{n} x_i$ | сумма | $x_1 + \dots + x_n$ | x.sum() |
| $\prod_{i=1}^{n} x_i$ | произведение | $x_1 \cdot \ldots \cdot x_n$ | x.prod() |
| $\lVert \mathbf{x} \rVert_2$ | норма | длина вектора | np.linalg.norm(x) |
| $\nabla_\theta L$ | градиент L по θ | вектор частных производных | loss.backward(); theta.grad |
| $\frac{\partial L}{\partial w}$ | частная производная | чувствительность L к w | — |
| $\mathbb{E}[X]$ | матожидание | среднее по распределению | x.mean() (оценка) |
| $p(y \mid x)$ | p от y при условии x | условная вероятность | выход модели |
| $\sim$ | распределено как | $x \sim \mathcal{N}(0, 1)$ | np.random.randn() |
| $\arg\max_x f(x)$ | аргмакс | точка, где f максимальна | np.argmax |
| $\odot$ | произведение Адамара | поэлементное умножение | a * b |
| $\mathbb{1}[\cdot]$ | индикатор | 1 если условие верно, иначе 0 | (cond).astype(int) |
| $\triangleq$, $:=$ | по определению | вводим обозначение | = |
| $\propto$ | пропорционально | равно с точностью до константы | — |
| $\theta$, $W$, $b$ | параметры | веса модели | model.parameters() |
| $\hat{y}$ | y с крышкой | предсказание модели | model(x) |
💡 Соглашение в ML: векторы — столбцы, но батч данных $X \in \mathbb{R}^{N \times d}$ хранит объекты в строках. Поэтому в статьях пишут $W\mathbf{x}$, а в коде —
X @ W.T.
Экспонента и логарифм — главная пара в ML
$$ \log(ab) = \log a + \log b, \qquad \log a^k = k \log a, \qquad e^{\log x} = x, \qquad \log e^{x} = x $$
Почему логарифмы везде: 1. Произведение → сумма. Правдоподобие $\prod_i p(y_i)$ из миллиона множителей < 1 даёт 0 в float. Сумма логарифмов $\sum_i \log p(y_i)$ — нормальное число. 2. Монотонность. $\arg\max_\theta \prod p = \arg\max_\theta \sum \log p$ — оптимум не меняется. 3. Удобные производные. $(\log x)' = 1/x$, $(e^x)' = e^x$.
import numpy as np
p = np.full(1000, 0.01)
print(np.prod(p))          # 0.0  — underflow
print(np.sum(np.log(p)))   # -4605.17 — всё в порядке
Сигмоида и softmax — превращают числа в вероятности
$$ \sigma(z) = \frac{1}{1 + e^{-z}}, \qquad \sigma'(z) = \sigma(z)\,(1 - \sigma(z)), \qquad \sigma(-z) = 1 - \sigma(z) $$
$$ \mathrm{softmax}(\mathbf{z})_i = \frac{e^{z_i}}{\sum_{j=1}^{K} e^{z_j}}, \qquad \sum_i \mathrm{softmax}(\mathbf{z})_i = 1 $$
- Сигмоида: одно число (логит) → вероятность класса 1 из 2.
- Softmax: K логитов → распределение по K классам. Сигмоида — частный случай softmax для K = 2: $\sigma(z) = \mathrm{softmax}([z, 0])_1$.
- Softmax не меняется от сдвига: $\mathrm{softmax}(\mathbf{z} + c) = \mathrm{softmax}(\mathbf{z})$ — на этом построен стабильный расчёт (модуль 13).
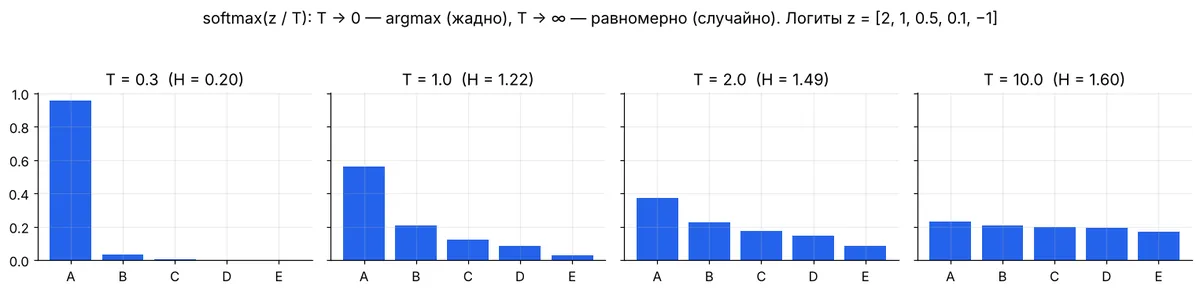
Температура $T$: $\mathrm{softmax}(\mathbf{z}/T)$. Маленькая T — уверенно и детерминированно, большая — разнообразно и случайно. Это та самая temperature в API LLM.
Полезные функции и их графики — запомнить «форму»
| Функция | Форма | Где в ML |
|---|---|---|
| $e^x$ | быстро растёт, всегда > 0 | softmax, правдоподобие |
| $\log x$ | медленно растёт, $\log 1 = 0$, $\to -\infty$ при $x \to 0$ | лоссы, энтропия |
| $-\log p$ | 0 при p = 1, → ∞ при p → 0 | cross-entropy: штраф за уверенную ошибку |
| $x^2$ | парабола, гладкая | MSE, L2-регуляризация |
| $\lvert x\rvert$ | «галочка», недифференцируема в 0 | MAE, L1-регуляризация |
| $\max(0, x)$ | ReLU | активации, hinge loss |
| $\log(1 + e^x)$ | softplus — гладкий ReLU | стабильная запись BCE |
Суммы, которые надо узнавать в лицо
$$ \sum_{i=1}^{n} i = \frac{n(n+1)}{2}, \qquad \sum_{k=0}^{\infty} r^k = \frac{1}{1-r}\ (|r| < 1), \qquad \frac{1}{n}\sum_{i=1}^{n} x_i = \bar{x} $$
Геометрическая прогрессия встречается в дисконтировании наград в RL ($\sum_t \gamma^t r_t$) и в экспоненциальном скользящем среднем в Adam и BatchNorm: вес наблюдения $k$ шагов назад равен $(1-\beta)\beta^k$, эффективное окно ≈ $1/(1-\beta)$ (β = 0.9 → ~10 шагов, β = 0.999 → ~1000).
🎯 На собеседовании
- Почему оптимизируют log-likelihood, а не likelihood? — Численная устойчивость (произведение → сумма) и тот же argmax.
- Чем softmax отличается от сигмоиды? — Softmax нормирует по K классам (взаимоисключающие), сигмоида даёт независимые вероятности (multi-label).
- Что делает температура? — Делит логиты: T < 1 обостряет распределение, T > 1 сглаживает.
🏋️ Практика модуля
1.1. Докажите, что $\sigma'(z) = \sigma(z)(1-\sigma(z))$, и проверьте численно.
▶️ Решение
$$ \sigma'(z) = \frac{e^{-z}}{(1+e^{-z})^2} = \frac{1}{1+e^{-z}} \cdot \frac{e^{-z}}{1+e^{-z}} = \sigma(z)\,\bigl(1-\sigma(z)\bigr) $$import numpy as np
s = lambda z: 1 / (1 + np.exp(-z))
z, h = 0.7, 1e-6
print((s(z + h) - s(z - h)) / (2 * h), s(z) * (1 - s(z))) # 0.2217 0.22171.2. Покажите, что softmax двух классов равен сигмоиде от разности логитов.
▶️ Решение
$$ \frac{e^{z_1}}{e^{z_1} + e^{z_2}} = \frac{1}{1 + e^{-(z_1 - z_2)}} = \sigma(z_1 - z_2) $$ Вывод: бинарный классификатор с 2 выходами и softmax эквивалентен 1 выходу с сигмоидой — лишний выход избыточен.1.3. Эффективное окно EMA с β = 0.99 — сколько шагов? Какой вес у наблюдения 100 шагов назад?
▶️ Решение
Окно ≈ $1/(1-0.99) = 100$ шагов. Вес: $(1 - 0.99) \cdot 0.99^{100} \approx 0.01 \cdot 0.366 = 0.0037$ — в $e \approx 2.7$ раза меньше веса свежего наблюдения (0.01).← 00½. База для начинающих: школьная математика за один вечер · 🏠 Оглавление · 02. Линейная алгебра →